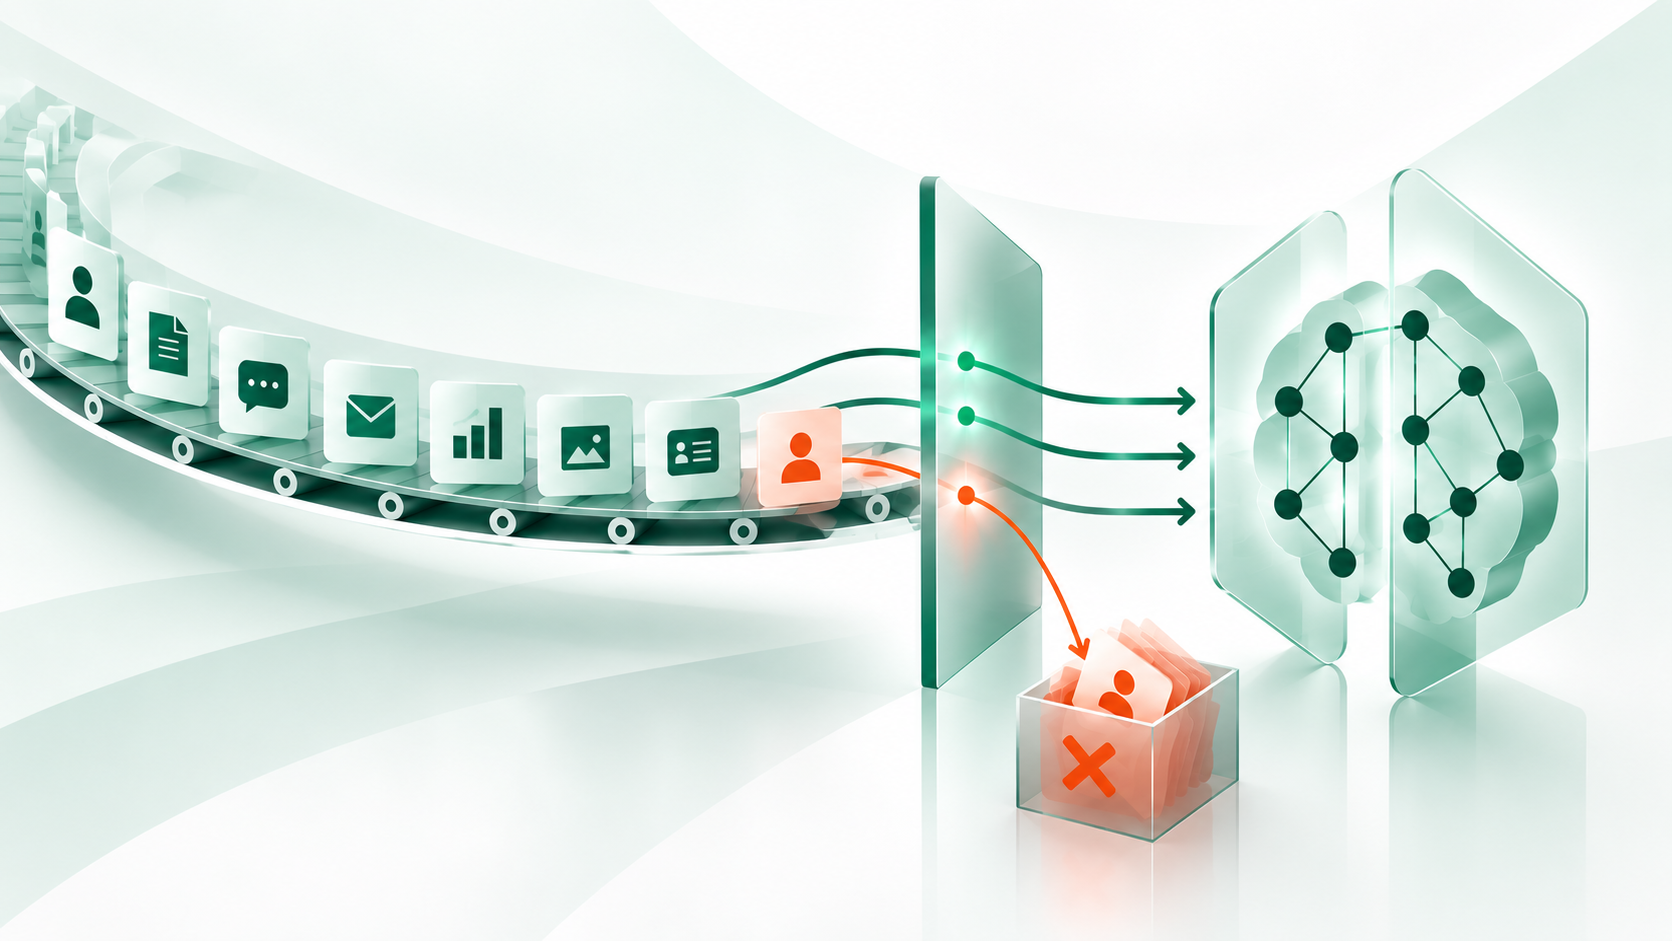
Datenschutz in KI-Systemen: Transparenz, Verantwortung und sichere Datenverarbeitung
Ein Unternehmen bindet einen Chatbot in den Kundenservice ein. Die Rechtsabteilung fragt nach dem Auftragsverarbeitungsvertrag, die IT hat den Zugang längst freigeschaltet. In dieser Reihenfolge läuft es oft, und in dieser Reihenfolge ist ein Verstoß bereits geschehen. Sobald die erste Kundenanfrage beim Anbieter landet, verarbeitet dieser personenbezogene Daten. Diese Verarbeitung setzt einen Vertrag nach Artikel 28 Absatz 3 der Datenschutz-Grundverordnung (DSGVO) voraus. Die DSGVO unterscheidet nicht, ob ein System pilotiert oder produktiv betrieben wird. Sie fragt, ob personenbezogene Daten verarbeitet werden.
Welche Rolle Ihr Unternehmen tatsächlich einnimmt
Bei jedem KI-Projekt steht zuerst die Frage der Verantwortlichkeit. Drei Konstellationen kommen in der Praxis häufig vor. Entwickelt und nutzt ein Unternehmen ein Modell vollständig selbst, ist es alleiniger Verantwortlicher. Setzt es ein KI-as-a-Service-Angebot ein und nutzt der Anbieter die anfallenden Prompts zur Verbesserung seines Modells für alle Kunden, entsteht regelmäßig eine gemeinsame Verantwortlichkeit nach Artikel 26 DSGVO, weil der Anbieter ein eigenes Interesse verfolgt. Trainiert ein Dienstleister ein Modell strikt nach Weisung und ohne eigene Zwecke, liegt Auftragsverarbeitung vor.
Die Rolle kann sich innerhalb desselben Projekts ändern. Ein Anbieter, der zunächst reiner Auftragsverarbeiter ist, wird zum gemeinsam Verantwortlichen, sobald er Kundendaten tenant-übergreifend fürs eigene Modelltraining verwendet. Wer das bei Vertragsabschluss nicht klärt, merkt es meist erst bei der nächsten Aktualisierung der Nutzungsbedingungen des Anbieters.
Die Rechtsgrundlage trägt selten allein die Einwilligung
Für das Training eigener Modelle mit vorhandenen Datenbeständen kommt in der Praxis meist das berechtigte Interesse nach Artikel 6 Absatz 1 lit. f DSGVO zum Tragen, nicht die Einwilligung. Der Grund ist banal: Bei Webscraping oder der Verwendung bestehender Kundendaten lässt sich eine wirksame, informierte Einwilligung kaum noch einholen. Der Europäische Datenschutzausschuss hat dafür in seiner Stellungnahme 28/2024 einen dreistufigen Test entwickelt. Es muss ein berechtigtes Interesse vorliegen, die Verarbeitung muss dafür erforderlich sein, und die Interessen der betroffenen Personen dürfen nicht überwiegen.
Wie belastbar dieser Ansatz ist, zeigt ein aktueller Fall. Das OLG Köln hat im Mai 2025 den Antrag der Verbraucherzentrale NRW gegen das KI-Training von Meta mit öffentlich einsehbaren Facebook- und Instagram-Beiträgen zurückgewiesen. Das Gericht sah kein milderes Mittel zur Verfolgung des Trainingszwecks und ließ die Interessenabwägung zugunsten von Meta ausfallen, auch weil die Nutzer vorab informiert wurden und widersprechen konnten. Für die eigene Praxis heißt das: Wer sich auf berechtigtes Interesse stützt, muss die drei Prüfschritte tatsächlich durchführen und dokumentieren, nicht nur behaupten.
Betroffenenanfragen, die niemand vollständig beantworten kann
Ein Punkt wird in Projekten regelmäßig unterschätzt. Fragt ein Betroffener nach Auskunft, Löschung oder Berichtigung seiner Daten in einem bereits trainierten Sprachmodell, stößt das Unternehmen an eine technische Grenze. In den Modellparametern eines Large Language Models (LLM) lässt sich kein einzelner Datenpunkt gezielt identifizieren oder entfernen, ohne das gesamte Modellverhalten zu verändern. Die Antwort stützt sich auf den unverhältnismäßigen Aufwand nach Artikel 12 Absatz 5 DSGVO: Das Unternehmen lehnt Auskunfts- und Löschansprüche mit einer technischen Begründung ab und sagt zu, die betreffenden Daten beim nächsten Trainingszyklus aus den Trainingsdaten zu entfernen.
Das gilt nicht für alle drei Szenarien gleich. Stammen die Trainingsdaten von einem externen Anbieter, kann das nutzende Unternehmen ohnehin nur eine Auskunft des Nichtwissens geben und muss die Anfrage weiterleiten. Hat es die Trainingsdaten selbst zusammengestellt, muss es tatsächlich Auskunft geben und Korrekturen im Ausgangsdatensatz vornehmen können. Bei laufenden Nutzereingaben (Prompts) gilt wiederum das normale DSGVO-Regime: Das Unternehmen muss Löschung und Aufbewahrung dokumentieren und nach Fristablauf umsetzen. Diese Differenzierung sollte in jeder internen Richtlinie zu Betroffenenanfragen stehen.
Wirksame Maßnahmen statt Grundsatzerklärungen
Vier technische und organisatorische Maßnahmen liefern in der Praxis den größten Effekt.
1) Ein vorgeschalteter Prompt-Filter reduziert die Eingabe personenbezogener Daten, bevor sie das System überhaupt erreicht. Er ersetzt keine Schulung, macht sie aber wirksamer, weil er die Fehler abfängt, die trotz Schulung passieren.
2) Unternehmen sollten vertraglich ausschließen, dass der Anbieter Eingaben in ein KI-Tool zum Weitertraining verwendet. Viele Anbieter bieten dafür eine technische Opt-Out-Einstellung, die aber häufig nur auf Nutzerebene und nicht zentral konfigurierbar ist. Wird sie nicht zentral gesetzt, hängt die Zweckbindung vom Verhalten Einzelner ab.
3) Pseudonymisierte Nutzerkonten und ein dokumentiertes Löschkonzept für Interaktionsprotokolle sind Pflicht, sobald ein Chatbot oder ein internes Tool über einen längeren Zeitraum Nutzeranfragen speichert.
4) Ein Berechtigungskonzept für den Zugriff auf KI-Systeme gehört ebenso zur Grundausstattung wie das bereits bekannte Verzeichnis von Verarbeitungstätigkeiten, das um die eingesetzten KI-Anwendungen ergänzt werden muss.
Wann eine Datenschutz-Folgenabschätzung zur Pflicht wird
Wer persönliche Aspekte systematisch und umfassend bewertet, etwa bei automatisierten Entscheidungen im Bewerbungsprozess oder bei der Kreditwürdigkeitsprüfung, muss eine Datenschutz-Folgenabschätzung nach Artikel 35 DSGVO durchführen. Dieselbe Pflicht entsteht, sobald ein KI-System besondere Kategorien personenbezogener Daten nach Artikel 9 DSGVO verarbeitet. Das betrifft KI-Systeme direkter, als es zunächst wirkt: Biometrische Identifikation, KI-gestützte Diagnostik in der Medizin und HR-Scoring-Tools, die aus Bewerbungsunterlagen auf Gesundheit oder ethnische Herkunft schließen können, arbeiten alle mit oder erzeugen Daten dieser Kategorie. In der Praxis wird die DSFA oft erst nachgeholt, wenn das System bereits im Einsatz ist, was rechtlich zu spät kommt und in der Dokumentation auffällt. Sie gehört vor den Rollout, nicht danach, und sie sollte mit der Grundrechte-Folgenabschätzung nach Artikel 27 der KI-VO koordiniert werden, wo diese zusätzlich greift.
Fazit
Die meisten datenschutzrechtlichen Probleme bei KI-Projekten entstehen nicht durch fehlendes Bewusstsein, sondern durch die falsche Reihenfolge. Verantwortlichkeit, Rechtsgrundlage und technische Maßnahmen gehören vor die Einführung, nicht in die Nachbereitung. Wer vorab klärt, welche Rolle das eigene Unternehmen einnimmt, und wer die Grenzen bei Betroffenenanfragen an bereits trainierten Modellen kennt, muss im Ernstfall nicht improvisieren, sondern kann auf eine dokumentierte Prüfung verweisen.
Wenn Sie Unterstützung bei der datenschutzkonformen Einführung von KI-Systemen benötigen, sprechen Sie uns gern an.