Nach dem Token: Wie neue KI-Architekturen die nächste Entwicklungsphase prägen
Die aktuelle Generation großer Sprachmodelle hat eine bemerkenswerte Innovationswelle ausgelöst. Doch die nächsten Fortschritte könnten aus ganz anderen Richtungen kommen. Neue KI-Architekturen treffen Entscheidungen ohne aufwendige Textgenerierung, erzeugen Inhalte parallel oder verarbeiten Informationen auf abstrakteren Ebenen. Einige sind bereits kommerziell verfügbar, andere befinden sich noch in der Forschung. Was leisten diese Verfahren, wo liegen ihre Grenzen und welche Bedeutung haben sie für Kosten, Geschwindigkeit und Qualität künftiger KI-Anwendungen?
Größer, schneller, besser. Aber muss KI so funktionieren?
Die Entwicklung künstlicher Intelligenz (KI) wird vor allem anhand neuer großer Sprachmodelle diskutiert. OpenAI, Anthropic, Google und weitere Anbieter konkurrieren mit zunehmend leistungsfähigen Modellen um die besten Ergebnisse bei Programmierung, Mathematik, Recherche und komplexer Problemlösung. Standardisierte Leistungstests, sogenannte Benchmarks, sollen die Fortschritte vergleichbar machen. Sie sind jedoch nur ein Anhaltspunkt: Ihre Aussagekraft hängt davon ab, welche Aufgaben untersucht wurden und wie gut diese den späteren Einsatz widerspiegeln.
Wer die Entwicklung ausschließlich an solchen Vergleichen misst, übersieht möglicherweise, welche technologischen Möglichkeiten sich bereits am Horizont abzeichnen. Die bekannten Sprachmodelle sind nicht der einzige Weg, künstliche Intelligenz leistungsfähiger zu machen. Es wurden und werden Architekturen entwickelt, die bestimmte Aufgaben anders lösen und damit neue Möglichkeiten für Geschwindigkeit, Wirtschaftlichkeit und Ergebnisqualität eröffnen.
Der technische Ausgangspunkt liegt in der Verarbeitung von Sprache. Ein Sprachmodell zerlegt eine Eingabe, den sogenannten Prompt, in einzelne Verarbeitungseinheiten, die Token. Diese entsprechen beispielsweise Wörtern, Wortteilen oder Satzzeichen. Die meisten verbreiteten großen Sprachmodelle arbeiten autoregressiv: Sie berechnen auf Grundlage der Eingabe und bereits erzeugter Token jeweils das nächste Token ihrer Antwort. Bei der klassischen Generierung benötigt eine Antwort mit tausend Token daher tausend aufeinanderfolgende Generierungsschritte. Zusätzliche Beschleunigungsverfahren können diese Verarbeitung optimieren.
Auch komplexe Aufgaben werden häufig mithilfe zusätzlicher sprachlicher Zwischenschritte bearbeitet. Solche Verfahren werden als Reasoning, also schlussfolgernde Verarbeitung, bezeichnet. Das ist leistungsfähig, verursacht aber zusätzlichen Rechenaufwand. Zugleich stellt sich die Frage, ob freie Textgenerierung überhaupt für jede Aufgabe das richtige Verfahren ist.
Fünf Entwicklungsrichtungen sind besonders interessant:
- Entscheidungsmodelle bewerten vorgegebene Optionen
- parallele und hierarchische Verfahren verändern die Textgenerierung
- Latent Reasoning verarbeitet Informationen ohne fortlaufende sprachliche Zwischenschritte
- rekursive Modelle verwenden kleine Netze mehrfach
- und Konzeptmodelle ergänzen die Verarbeitung um abstraktere gelernte Repräsentationen.
Diese Entwicklungen befinden sich auf unterschiedlichen Reifestufen und sind nicht unmittelbar miteinander vergleichbar. Ihr gemeinsamer Anspruch lässt sich dennoch anhand von drei Fragen untersuchen: Welche Kosten verursacht die Verarbeitung? Wie schnell liegt ein Ergebnis vor? Und welche Qualität erreicht es bei der vorgesehenen Aufgabe?
1. Entscheidungsmodelle: Bewerten statt generieren
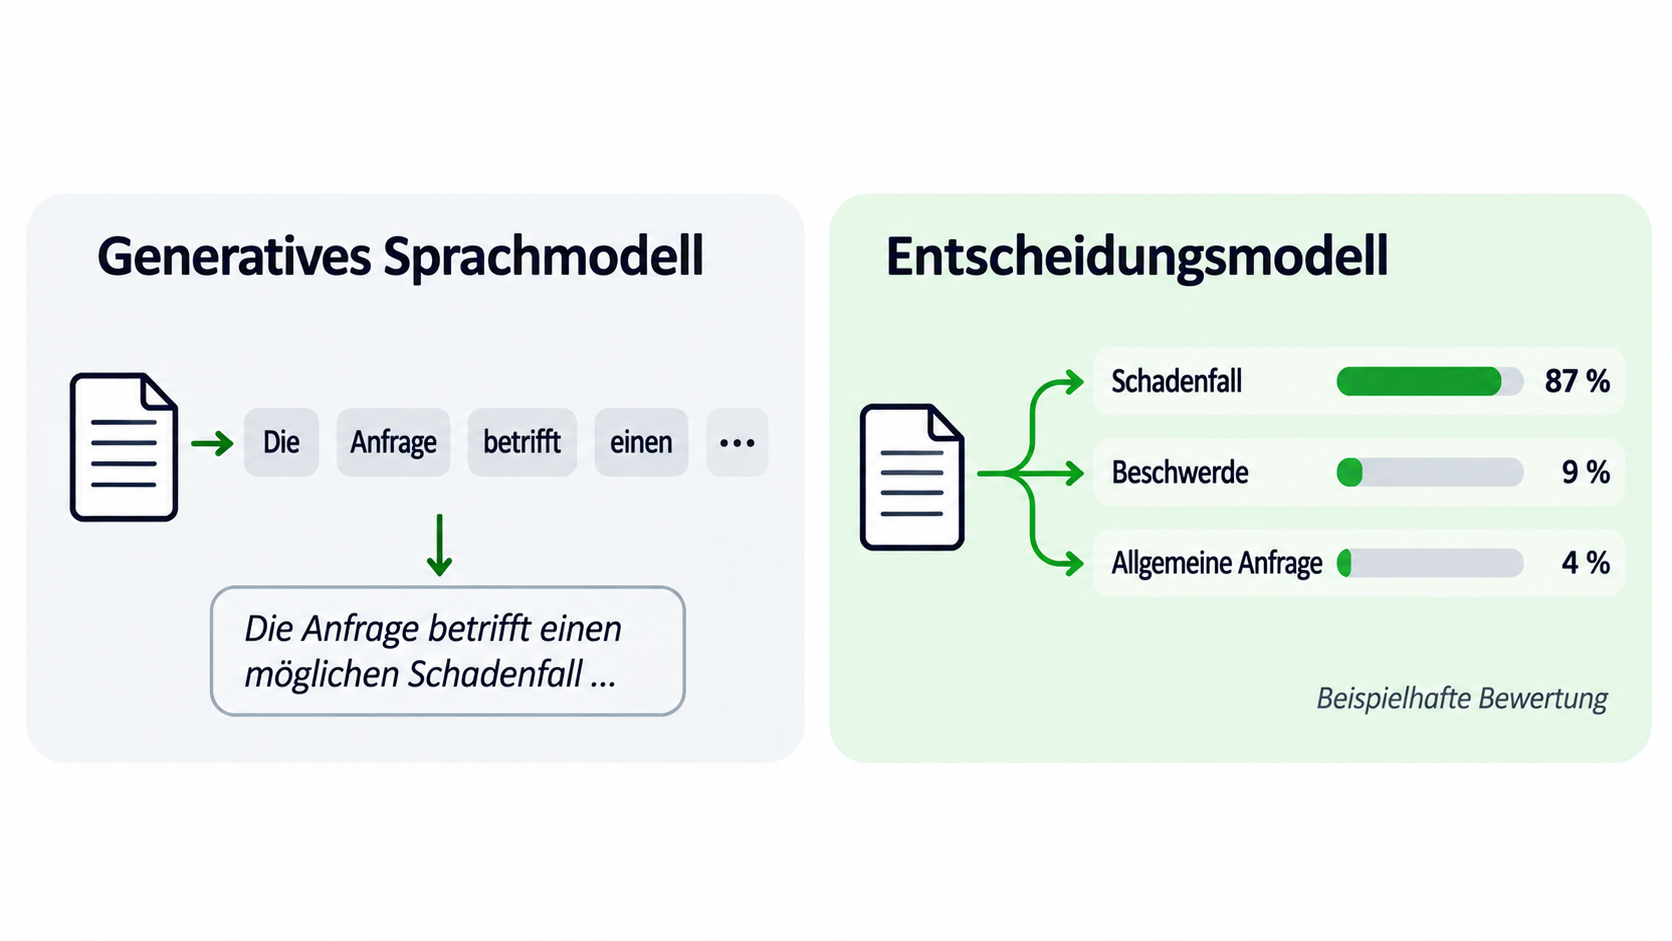
Viele Aufgaben in Unternehmen erfordern keine frei formulierte Antwort. Dokumente müssen kategorisiert, Kundenanfragen priorisiert oder Informationen anhand festgelegter Kriterien bewertet werden. Generative Sprachmodelle können diese Aufgaben übernehmen, verwenden dafür aber einen Mechanismus, der auch auf die Erzeugung beliebiger neuer Inhalte ausgelegt ist.
Spezialisierte Entscheidungsmodelle konzentrieren sich dagegen auf strukturierte Bewertungen. Sie erhalten eine Eingabe und eine Menge vorgegebener Antwortmöglichkeiten. Das Modell bestimmt in einem Durchlauf Wahrscheinlichkeitswerte für die möglichen Ergebnisse, ohne dafür eine längere Antwort Token für Token formulieren zu müssen.
Ein Unternehmen könnte beispielsweise eine eingehende Kundenanfrage analysieren lassen. Als mögliche Kategorien werden „Beschwerde“, „Schadenfall“ und „Allgemeine Anfrage“ vorgegeben. Das Modell bewertet die drei Optionen und gibt seine Einschätzung in einem strukturierten Datenformat zurück. Die folgende Abbildung verdeutlicht den Unterschied zwischen der schrittweisen Textgenerierung und einer direkten Bewertung definierter Optionen.
Dass dieser Ansatz bereits praktisch nutzbar ist, zeigen Jev von TypeSafe AI und Microsoft-Decision-1, die beide im Herbst 2026 vorgestellt wurden. Microsofts Modell basiert auf einem nachtrainierten Sprachmodell mit neun Milliarden Parametern, ist jedoch gezielt auf strukturierte Entscheidungsaufgaben spezialisiert.
Kosten, Zeit und Qualität
Zeit: Ein wesentlicher Vorteil spezialisierter Entscheidungsmodelle liegt in ihrer geringen Antwortlatenz. Da keine längere Textsequenz erzeugt werden muss, können strukturierte Bewertungen wesentlich schneller erfolgen. TypeSafe AI nennt für Jev Antwortzeiten zwischen 70 und 500 Millisekunden. Auch Microsoft-Decision-1 erzielt nach Herstellerangaben erhebliche Geschwindigkeitsvorteile gegenüber den untersuchten generativen Sprachmodellen. Die Werte stammen aus unterschiedlichen Testbedingungen und sind daher nicht unmittelbar vergleichbar.
Kosten: Beide Anbieter nennen einen Preis von 0,042 US-Dollar je Million Eingabe-Token. Für die strukturierte Ausgabe fallen nach den veröffentlichten Preismodellen keine zusätzlichen Tokenkosten an. Damit können Entscheidungsmodelle insbesondere bei großen Verarbeitungsmengen wirtschaftlich interessant sein. Die tatsächlichen Gesamtkosten einer Anwendung hängen allerdings auch von Integration, Infrastruktur, Betrieb und möglicher Nachbearbeitung ab.
Qualität: Jev und Microsoft-Decision-1 setzen unterschiedliche Schwerpunkte. TypeSafe AI hebt insbesondere die Kalibrierung der ausgegebenen Wahrscheinlichkeiten und die zuverlässige Einhaltung vorgegebener Ausgabeformate hervor. Microsoft berichtet von hoher Genauigkeit über unterschiedliche Klassifikations- und Bewertungsaufgaben hinweg. Die Ergebnisse sind vielversprechend, beruhen jedoch überwiegend auf herstellerseitigen Untersuchungen. Eine allgemeine Überlegenheit eines der beiden Modelle lässt sich daraus nicht ableiten. Entscheidend bleibt, wie zuverlässig ein Modell die konkrete Unternehmensaufgabe erfüllt.
Die vorgegebenen Antwortmöglichkeiten verhindern zwar, dass ein Modell beliebige neue Kategorien erfindet. Eine falsche Bewertung bleibt dennoch möglich. Ebenso müssen die ausgegebenen Wahrscheinlichkeiten überprüft werden. Bei einem gut kalibrierten Modell sollten beispielsweise von hundert Entscheidungen, die mit 90 Prozent Sicherheit bewertet werden, langfristig ungefähr neunzig richtig sein. Ob das für einen konkreten Anwendungsfall gilt, muss anhand geeigneter Testdaten festgestellt werden.
Besonders interessant sind Entscheidungsmodelle deshalb für standardisierte Prozesse mit hohen Fallzahlen, etwa die Vorsortierung von Dokumenten oder die Auswahl geeigneter Werkzeuge innerhalb eines KI-Agenten. Ein solcher Agent kann Aufgaben über mehrere Verarbeitungsschritte bearbeiten und dabei beispielsweise Datenbanken oder externe Anwendungen nutzen. Vor dem Einsatz sollte allerdings geprüft werden, ob die Aufgabe überhaupt KI benötigt. Eindeutige Regeln lassen sich häufig mit klassischer Software zuverlässiger und günstiger umsetzen.
Die eigentliche Innovation liegt nicht darin, dass KI Entscheidungen treffen kann. Sie liegt darin, bestimmte Bewertungsaufgaben ohne den Aufwand freier Textgenerierung bearbeiten zu können.
2. Parallele und hierarchische Generierung: Nicht mehr ausschließlich Token für Token
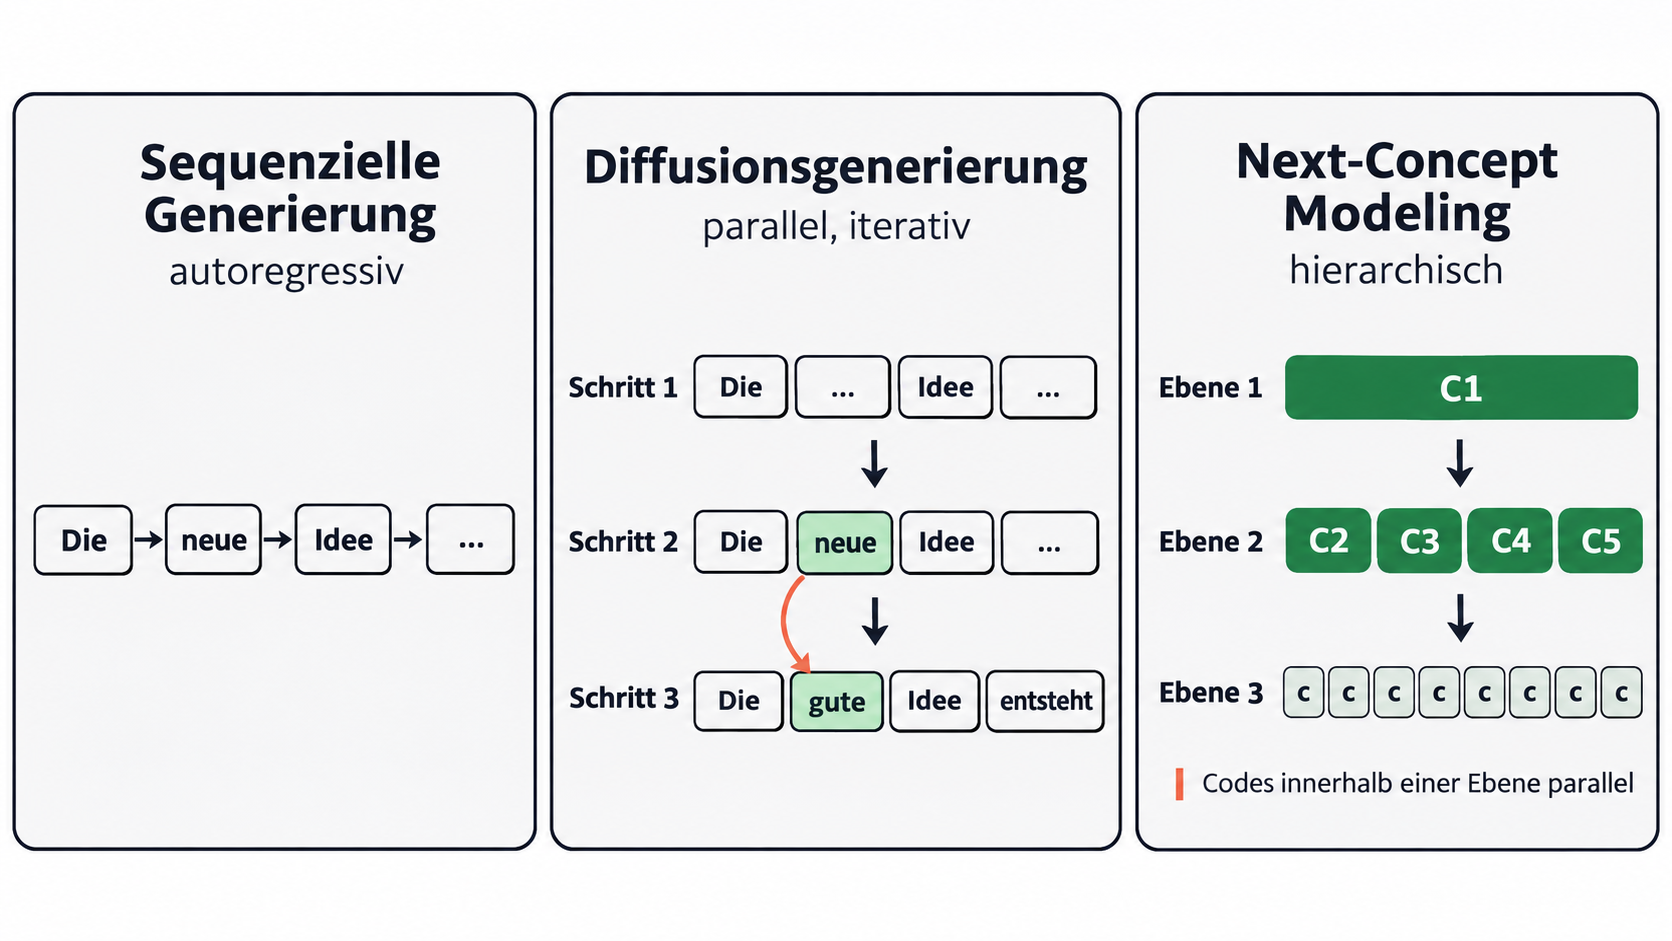
Bei Entscheidungsmodellen entfällt die freie Textgenerierung weitgehend. Andere Forschungsrichtungen versuchen dagegen, die Textgenerierung selbst zu verändern. Ein Ansatz sind Diffusions-Sprachmodelle. Das Prinzip ist aus der Bildgenerierung bekannt: Statt ein Ergebnis ausschließlich Element für Element aufzubauen, wird eine zunächst unvollständige Repräsentation über mehrere Schritte verbessert. Bei Sprache können dafür verschiedene Positionen einer Textsequenz parallel vorhergesagt und anschließend überarbeitet werden.
Im Unterschied zur klassischen autoregressiven Generierung muss damit nicht jede Position erst nach der endgültigen Festlegung aller vorhergehenden Positionen berechnet werden. Auch bereits erzeugte Inhalte können je nach Verfahren in späteren Schritten verändert werden.
Diffusionsmodelle werden kommerziell verfügbar
Mit Mercury 3 bietet Inception Labs ein kommerzielles Diffusions-Sprachmodell an. Der Hersteller gibt eine Generierungsgeschwindigkeit von mehr als tausend Token pro Sekunde an. Zum Vergleich: Auch schnelle autoregressive Modelle erreichen hohe Ausgabegeschwindigkeiten, jedoch können die Werte je nach Hardware, Modell und Aufgabe erheblich variieren. Ein isolierter Geschwindigkeitswert erlaubt deshalb noch keinen fairen Produktvergleich.
Inception berichtet, dass Mercury 3 bei ausgewählten Tests mit anderen auf Geschwindigkeit optimierten Sprachmodellen konkurrieren kann. Die Angaben stammen vom Hersteller. Ob ein vergleichbares Qualitätsniveau für anspruchsvolle Unternehmensaufgaben erreicht wird, muss im jeweiligen Einsatz geprüft werden.
Ein zweites Beispiel ist DiffusionGemma von Google. Das 2026 veröffentlichte Forschungsmodell zeigt, dass sich ein ursprünglich autoregressives Sprachmodell durch gezieltes Nachtraining auf diffusionsbasierte Generierung umstellen lässt. Diese Möglichkeit ist technologisch bedeutsam, weil beide Verfahren damit nicht zwangsläufig vollständig getrennte Modellwelten bleiben müssen.
Next-Concept Modeling: Vom Groben zum Detail
Einen anderen Weg verfolgt Next-Concept Modeling. Das Verfahren arbeitet mit einer hierarchischen Repräsentation von Text. Zunächst wird eine grobe Struktur erzeugt, anschließend folgen zunehmend detaillierte Ebenen. Innerhalb jeder Ebene können mehrere Bestandteile parallel vorhergesagt werden.
Die Unterscheidung ist wichtig: Diffusionsmodelle verbessern eine Textrepräsentation iterativ. Next-Concept Modeling baut das Ergebnis dagegen über mehrere hierarchische Repräsentationsebenen auf. Beide Verfahren ermöglichen parallele Berechnungen, verwenden dafür jedoch unterschiedliche technische Mechanismen. Die folgende Abbildung stellt die klassische sequenzielle Generierung diesen beiden Alternativen gegenüber.
Kosten, Zeit und Qualität
Zeit: Hier liegt das bislang am deutlichsten erkennbare Potenzial. Mercury 3 erreicht nach Herstellerangaben sehr hohe Ausgabegeschwindigkeiten. Die Forscher hinter Next-Concept Modeling berichten ebenfalls von erheblichen Beschleunigungen gegenüber den untersuchten experimentellen Vergleichsverfahren. Diese Ergebnisse sind jedoch nicht ohne Weiteres zwischen Produkten und Forschungsarbeiten übertragbar.
Kosten: Schnellere Verarbeitung kann die Nutzungskosten senken, muss es aber nicht. Entscheidend dafür ist, wie viel Rechenleistung, Speicher und Hardwarekapazität tatsächlich benötigt werden. Bei Diffusionsverfahren hängt dies unter anderem von der Anzahl der Verfeinerungsschritte ab. Für einen belastbaren Wirtschaftlichkeitsvergleich müssen die Kosten pro erfolgreich abgeschlossener Aufgabe betrachtet werden.
Qualität: Die Ergebnisse unterscheiden sich je nach Aufgabe und Modell erheblich. Besonders bei komplexen Aufgaben oder bei der exakten Übernahme von Namen, Beträgen und Kennungen können Qualitätsprobleme auftreten. Hierarchische Verfahren bringen zudem eigene mögliche Fehlerquellen bei der Rekonstruktion von Text mit. Die Forschung zeigt interessante Fortschritte, aber noch keine allgemeine Überlegenheit gegenüber autoregressiven Sprachmodellen.
Für Unternehmen sind diese Verfahren insbesondere dort relevant, wo Antwortzeiten eine wesentliche Rolle spielen. Das betrifft Sprachdialogsysteme, interaktive Assistenzanwendungen und KI-Agenten, deren einzelne Verarbeitungsschritte sich zeitlich summieren.
Die Textgenerierung muss nicht ausschließlich sequenziell erfolgen. Parallele und hierarchische Verfahren eröffnen neue Möglichkeiten zur Beschleunigung, deren Nutzen jedoch stets gegen Rechenaufwand und Ergebnisqualität abgewogen werden muss.
3. Latent Reasoning: Berechnungen ohne sprachliche Zwischenschritte
Eine weitere Forschungsrichtung verändert nicht vorrangig die Textausgabe, sondern die interne Verarbeitung komplexer Aufgaben. Sprachmodelle arbeiten intern mit mathematischen Repräsentationen. Diese bestehen aus Zahlenwerten, die Informationen und Zusammenhänge in einem sogenannten latenten Raum abbilden. Bei klassischer autoregressiver Verarbeitung wird aus diesen internen Zuständen wiederholt das nächste Token bestimmt.
Für komplexe Aufgaben nutzen viele sogenannte Reasoning-Modelle zusätzliche Verarbeitungsschritte, die teilweise als sprachliche Zwischenschritte erfolgen. Das kann bei der Problemlösung hilfreich sein, verursacht aber zusätzlichen Aufwand. Deshalb untersucht die Forschung, ob ein Modell interne Zustände unmittelbar weiterverarbeiten kann, ohne jeden Zwischenschritt zunächst in Sprache umzuwandeln.
Ein früher Ansatz ist Coconut, den Forschende von Meta 2024 vorstellten. Das Verfahren führt Berechnungen im latenten Raum fort und erzeugt erst bei Bedarf wieder sprachliche Ausgaben. Die Untersuchungen zeigen Vorteile bei bestimmten logischen Aufgaben, erlauben aber keine allgemeine Aussage über die Überlegenheit dieses Verfahrens.
HybridAgent verbindet internes Rechnen mit Werkzeugen
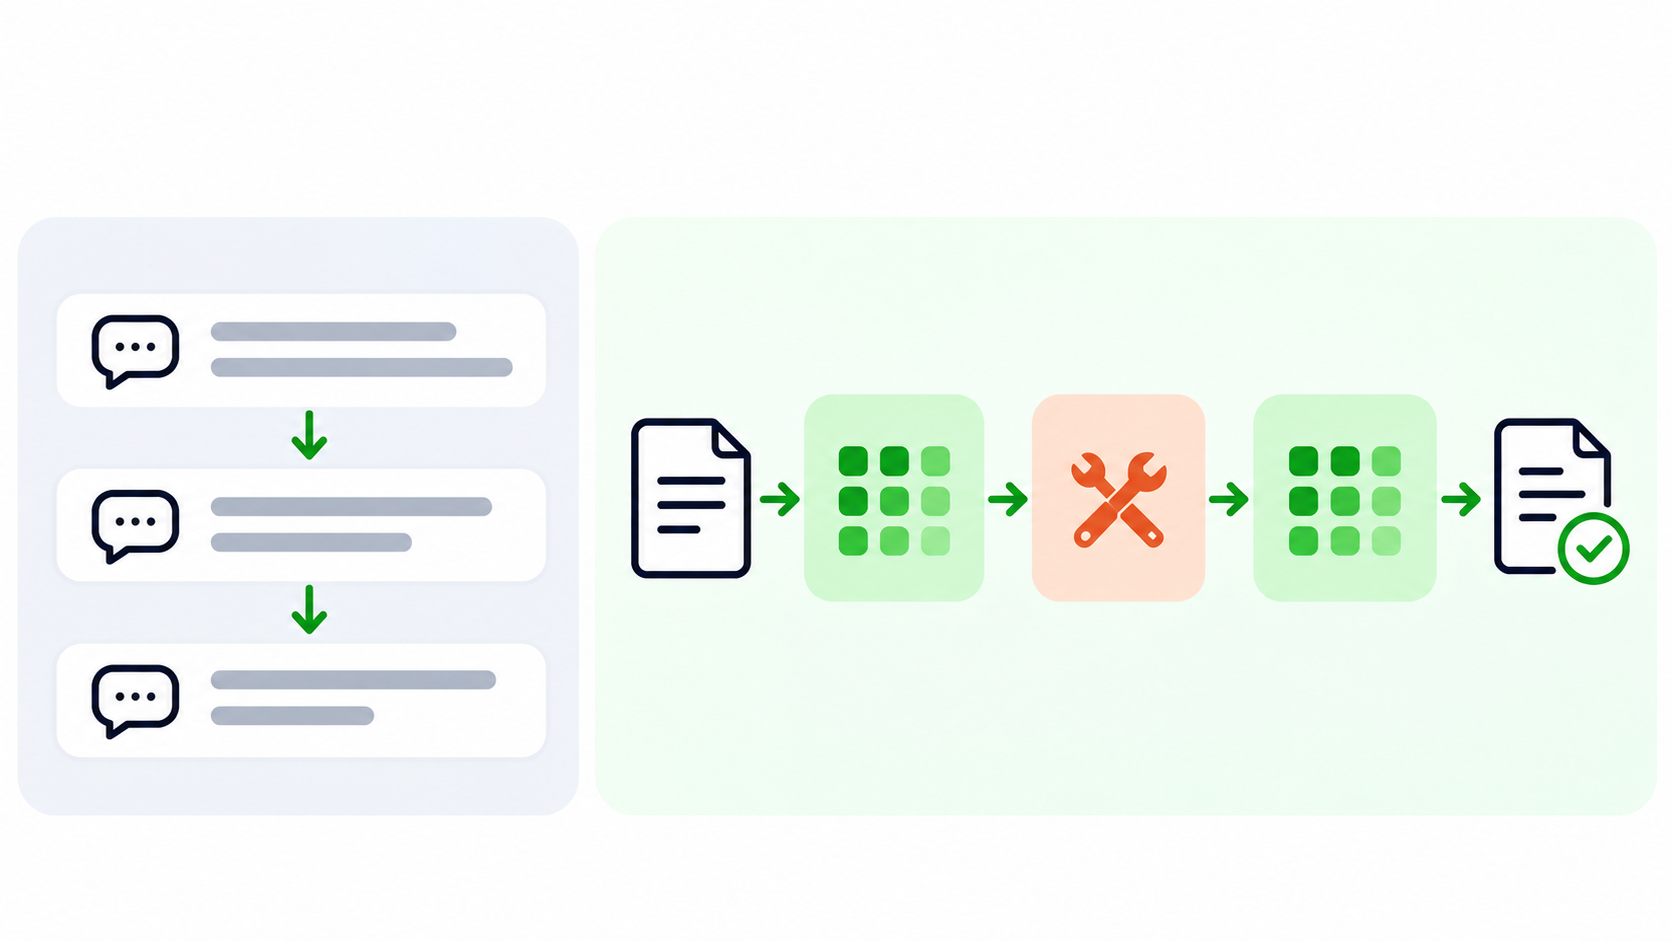
Einen Schritt weiter geht die im Oktober 2026 veröffentlichte Forschungsarbeit Hybrid Reasoning Agents. Ihr Ansatz kombiniert die interne latente Verarbeitung mit der Fähigkeit, bei Bedarf in einen textbasierten Modus zu wechseln.
Das ist vor allem für KI-Agenten interessant. Ein Agent könnte zunächst intern einen Lösungsweg entwickeln, anschließend über eine Programmierschnittstelle Informationen abrufen, diese weiterverarbeiten und schließlich eine Antwort formulieren. Nicht jeder interne Zwischenschritt müsste dafür als Text erzeugt werden. Die folgende Abbildung zeigt diesen Wechsel zwischen latenter Verarbeitung und sprachlicher beziehungsweise strukturierter Interaktion mit der Umgebung.
Kosten, Zeit und Qualität
Zeit: Die Forscher berichten bei ihren untersuchten Aufgaben von einer ungefähr zwei- bis dreifachen Beschleunigung gegenüber verschiedenen textbasierten und latenten Vergleichssystemen.
Kosten: Unter den Bedingungen der Untersuchung wurden die erzeugten Token deutlich reduziert und die modellierten Nutzungskosten entsprechend gesenkt. Weniger Token bedeuten allerdings nicht automatisch einen proportional geringeren Rechenaufwand. Entscheidend bleibt, welche Ressourcen die internen Berechnungen benötigen.
Qualität: Die Forschungsarbeit berichtet von durchschnittlichen Leistungsverbesserungen gegenüber den untersuchten Referenzsystemen, darunter auch leistungsfähige agentische Sprachmodelle. Die Ergebnisse stammen jedoch aus kontrollierten Untersuchungen. Ob die Vorteile auch bei praktischen Unternehmensaufgaben bestehen bleiben, ist noch offen.
Neben diesen Leistungsdimensionen entsteht eine weitere Frage: Wie lässt sich eine Verarbeitung beurteilen, deren interne Berechnungen nicht unmittelbar sprachlich dargestellt werden? Dabei sollte zwischen Transparenz und Kontrollierbarkeit unterschieden werden. Eine ausgeschriebene Gedankenkette heutiger Reasoning-Modelle ist ebenfalls kein vollständiges Protokoll ihrer tatsächlichen internen Berechnungen. Umgekehrt bedeutet ein schwer interpretierbarer interner Zustand nicht, dass ein gesamtes KI-System unkontrollierbar sein muss.
Für Unternehmen ist entscheidend, welche Eingaben, Datenquellen, Werkzeugaufrufe und Ergebnisse nachvollzogen werden können. Wie weit zusätzlich eine Untersuchung interner Modellzustände erforderlich ist, hängt vom Anwendungsfall, den Risiken und dem vertretbaren Kontrollaufwand ab.
Latent Reasoning eröffnet die Möglichkeit, interne Berechnung und sprachliche Interaktion stärker voneinander zu trennen. Ob daraus ein wirtschaftlicher Vorteil entsteht, hängt von der Leistungsfähigkeit des Gesamtsystems und seinem tatsächlichen Ressourcenbedarf ab.
4. Rekursive Modelle: Mehr Rechentiefe statt immer größerer Netze
Die Leistungsfähigkeit neuronaler Netze wurde in den vergangenen Jahren unter anderem durch größere Modelle, umfangreichere Trainingsdaten und steigenden Rechenaufwand verbessert. Die Anzahl der Modellparameter allein ist jedoch kein zuverlässiges Maß für die Qualität der Ergebnisse. Rekursive Ansätze untersuchen deshalb, ob sich Aufgaben auch durch die wiederholte Anwendung eines kleineren neuronalen Netzes lösen lassen.
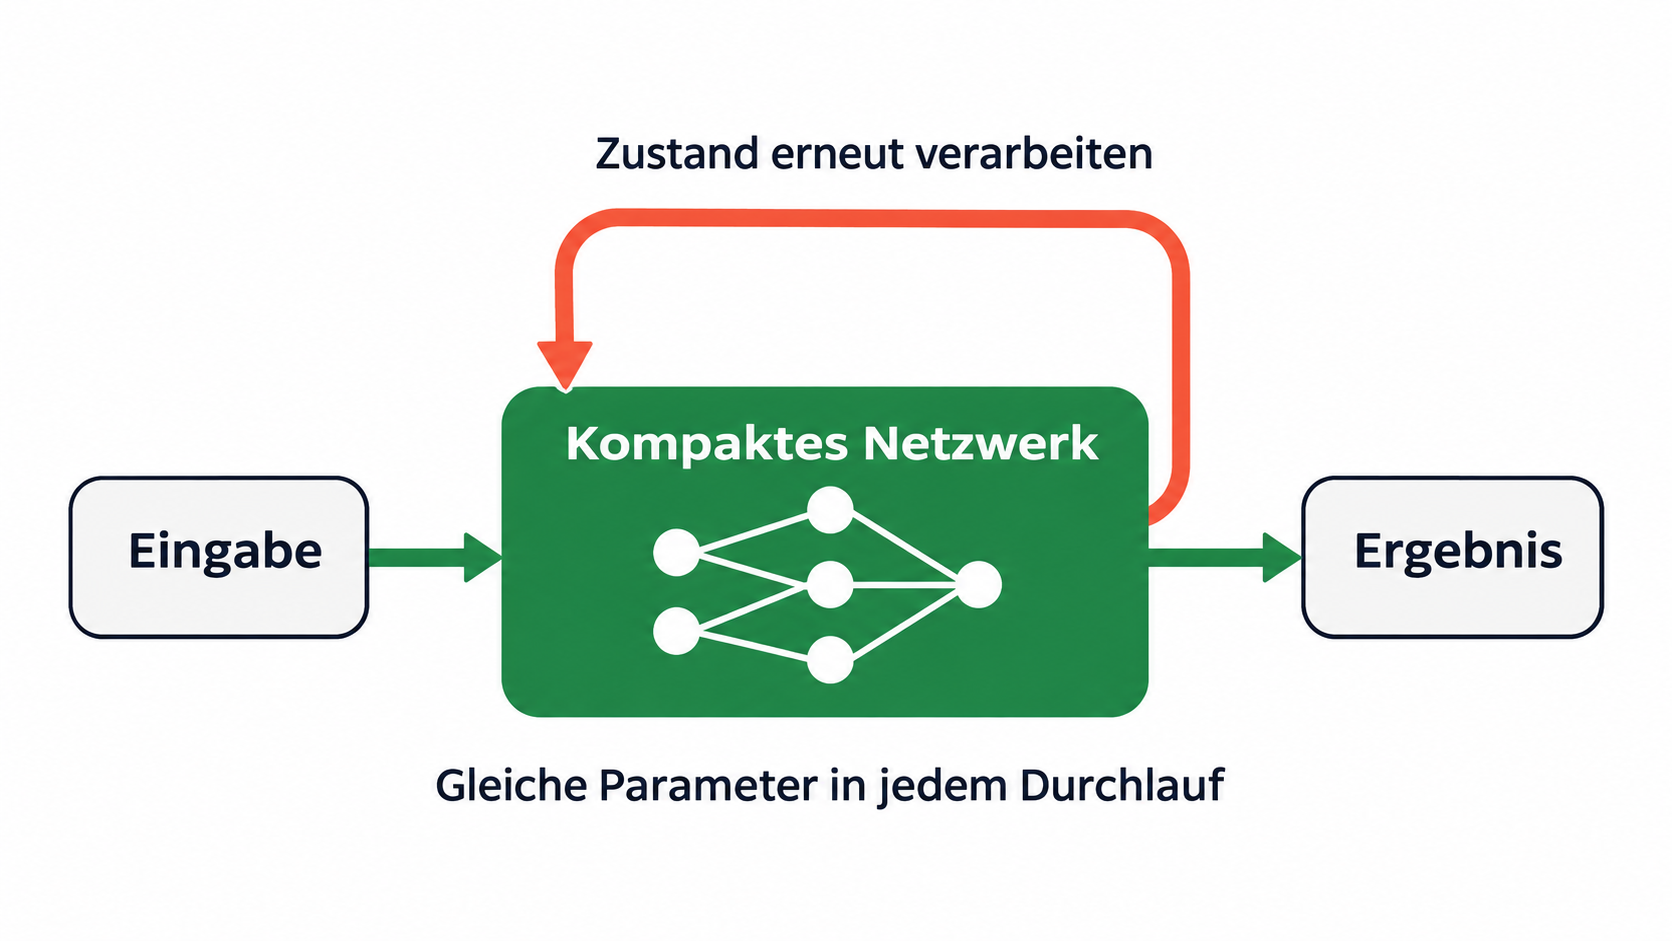
Das 2025 vorgestellte Tiny Recursive Model verwendet ein kompaktes Netzwerk, das mehrfach auf interne Zwischenergebnisse angewendet wird. Das Modell verarbeitet eine Aufgabe also nicht nur einmal, sondern verbessert seine Zustandsrepräsentation in aufeinanderfolgenden Berechnungsschritten. Dabei werden dieselben Modellparameter wiederverwendet. Die folgende Abbildung zeigt, wie ein kleines Netzwerk wiederholt durchlaufen wird.
Kosten, Zeit und Qualität
Zeit: Die wiederholte Anwendung eines Modells erzeugt zusätzliche Berechnungsschritte. Rekursion führt deshalb nicht zwangsläufig zu kürzeren Antwortzeiten. Ihre Effizienz hängt davon ab, wie viel Fortschritt die einzelnen Durchläufe erzielen.
Kosten: Eine geringe Parameterzahl kann Speicherbedarf und Hardwareanforderungen reduzieren. Gleichzeitig können zahlreiche Wiederholungen den tatsächlichen Rechenaufwand erhöhen. Ein kleines Modell ist daher nicht automatisch günstiger als ein größeres.
Qualität: Das Tiny Recursive Model erreichte mit ungefähr sieben Millionen Parametern bemerkenswerte Ergebnisse auf Tests zur Erkennung abstrakter Muster. Auf einem anspruchsvolleren Test fiel die Genauigkeit allerdings deutlich geringer aus. Die Resultate zeigen, dass kleine rekursive Netze bei bestimmten Aufgaben leistungsfähig sein können, nicht jedoch, dass sie universelle Sprachmodelle ersetzen.
Für Unternehmen ist diese Entwicklung vor allem langfristig interessant. Sollte sich das Prinzip auf weitere Aufgaben übertragen lassen, könnten spezialisierte Systeme mit vergleichsweise geringem Speicherbedarf entstehen. Ob solche Modelle wirtschaftlich überlegen sind, lässt sich aber nur unter Berücksichtigung ihrer gesamten Berechnungskosten beurteilen.
Die Forschung zeigt, dass Modellgröße nicht der einzige Weg zu höherer Leistungsfähigkeit ist. Wiederholte Berechnungen können bei geeigneten Aufgaben einen Teil der fehlenden Modellkapazität ausgleichen.
5. Konzeptmodelle: Informationen auf einer abstrakteren Ebene verarbeiten
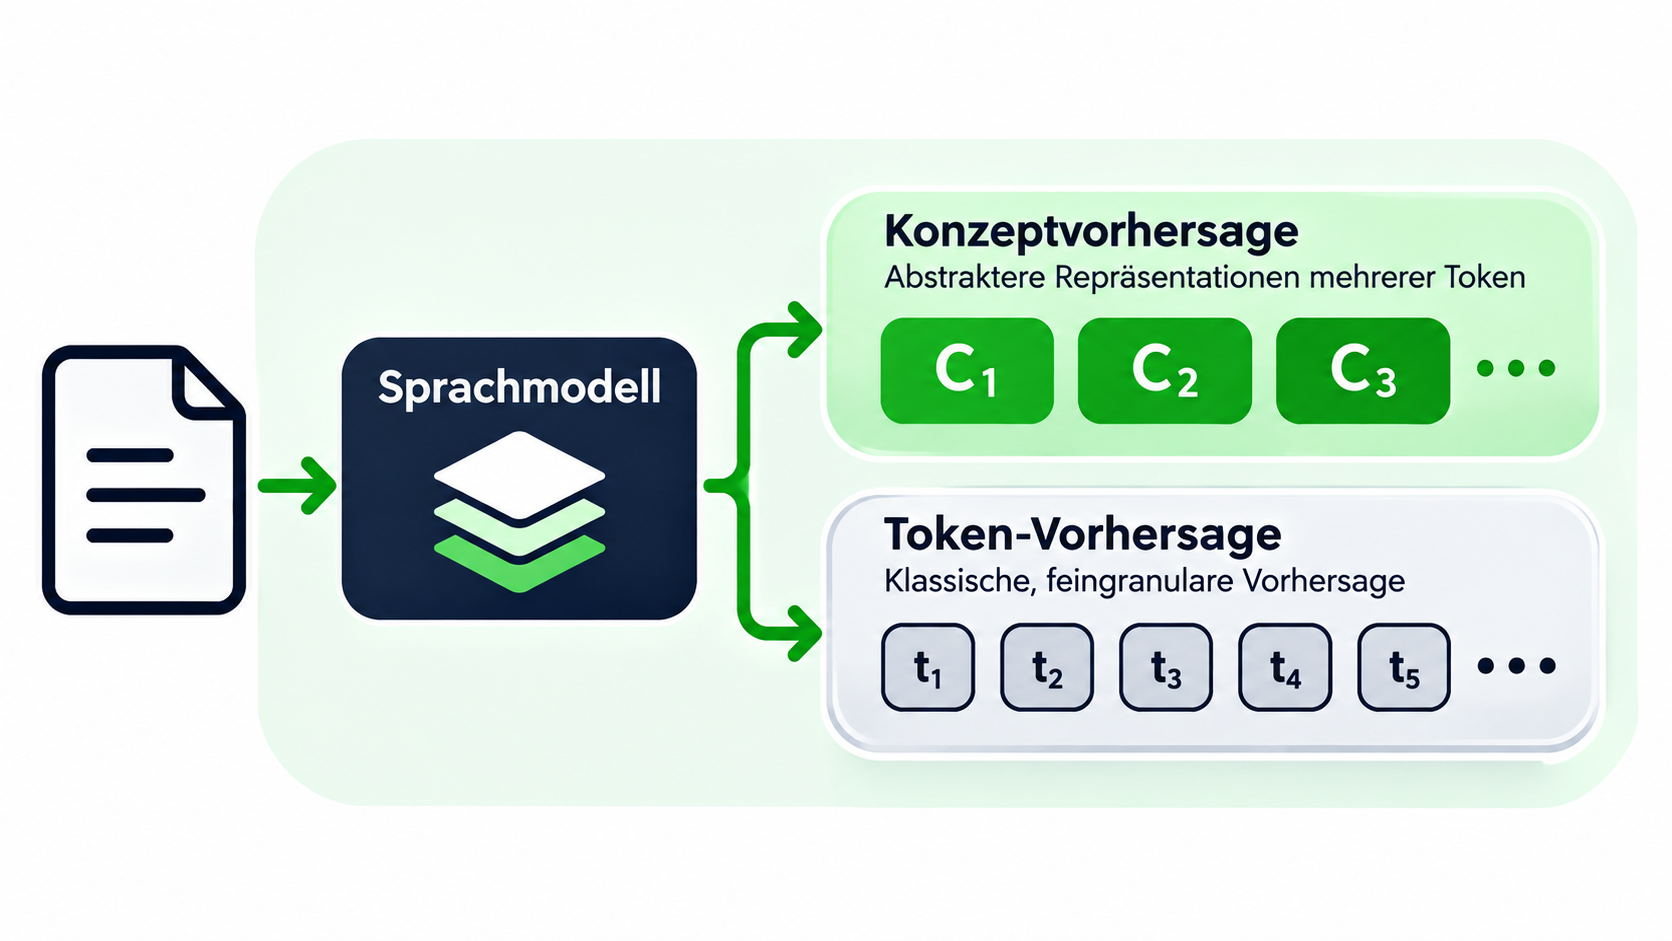
Während rekursive Modelle die Wiederholung von Berechnungen verändern, beschäftigen sich Konzeptmodelle mit der Frage, auf welcher Ebene Informationen repräsentiert werden. Klassische Sprachmodelle lernen vor allem, das nächste Token vorherzusagen. Damit erfassen sie bereits komplexe sprachliche Zusammenhänge. Neuere Forschungsansätze untersuchen jedoch, ob ein zusätzliches Lernziel auf einer abstrakteren Ebene die Fähigkeiten verbessern kann.
Ein Beispiel ist ConceptLM, das im Februar 2026 vorgestellt wurde. Das Modell lernt neben der klassischen Token-Vorhersage auch sogenannte diskrete Konzepte. Dabei handelt es sich um gelernte interne Repräsentationen, die Informationen aus mehreren Token zusammenfassen können.
Diese Konzepte sind keine fest vorgegebenen Begriffe oder unmittelbar lesbaren Kategorien. Es sind mathematisch gelernte Repräsentationen, die das Modell zusätzlich zur Verarbeitung einzelner Token nutzt. Die Konzeptvorhersage ergänzt damit das bestehende Trainingsverfahren, statt es vollständig zu ersetzen. Die folgende Abbildung verdeutlicht die beiden ergänzenden Lernziele.
Kosten, Zeit und Qualität
Zeit: Die Veröffentlichung liefert noch keine belastbare Grundlage dafür, dass ConceptLM im praktischen Betrieb grundsätzlich schneller ist als vergleichbare klassische Sprachmodelle. Die zusätzliche Verarbeitungsebene kann selbst Rechenaufwand verursachen.
Kosten: Auch ein allgemeiner Kostenvorteil ist bislang nicht nachgewiesen. Interessant wäre langfristig, ob eine effizientere interne Repräsentation bei vergleichbarer Modellgröße bessere Ergebnisse ermöglicht und damit den Bedarf an größeren Modellen verringern kann.
Qualität: Hier liegen die bisher aussagekräftigsten Ergebnisse vor. Die Autoren berichten bei mehreren untersuchten Modellgrößen von Verbesserungen gegenüber den jeweiligen Vergleichsmodellen. Auch beim Weitertraining eines größeren Sprachmodells wurden positive Effekte beobachtet. Daraus folgt jedoch noch keine allgemeine Überlegenheit bei komplexer Problemlösung oder beim Verständnis fachlicher Zusammenhänge.
Konzeptmodelle sind deshalb vor allem eine interessante Forschungsrichtung für die Weiterentwicklung bestehender Sprachmodelle. Es ist denkbar, dass entsprechende Verfahren künftig in größere Modelle einfließen, ohne für Anwender als eigenständige Produktkategorie sichtbar zu werden.
Abstraktere Repräsentationen könnten Sprachmodelle leistungsfähiger machen, ohne dass dafür ausschließlich ihre Parameterzahl steigen muss. Ob sich daraus auch wirtschaftliche Vorteile ergeben, ist noch offen.
Was Unternehmen aus diesen Entwicklungen ableiten können
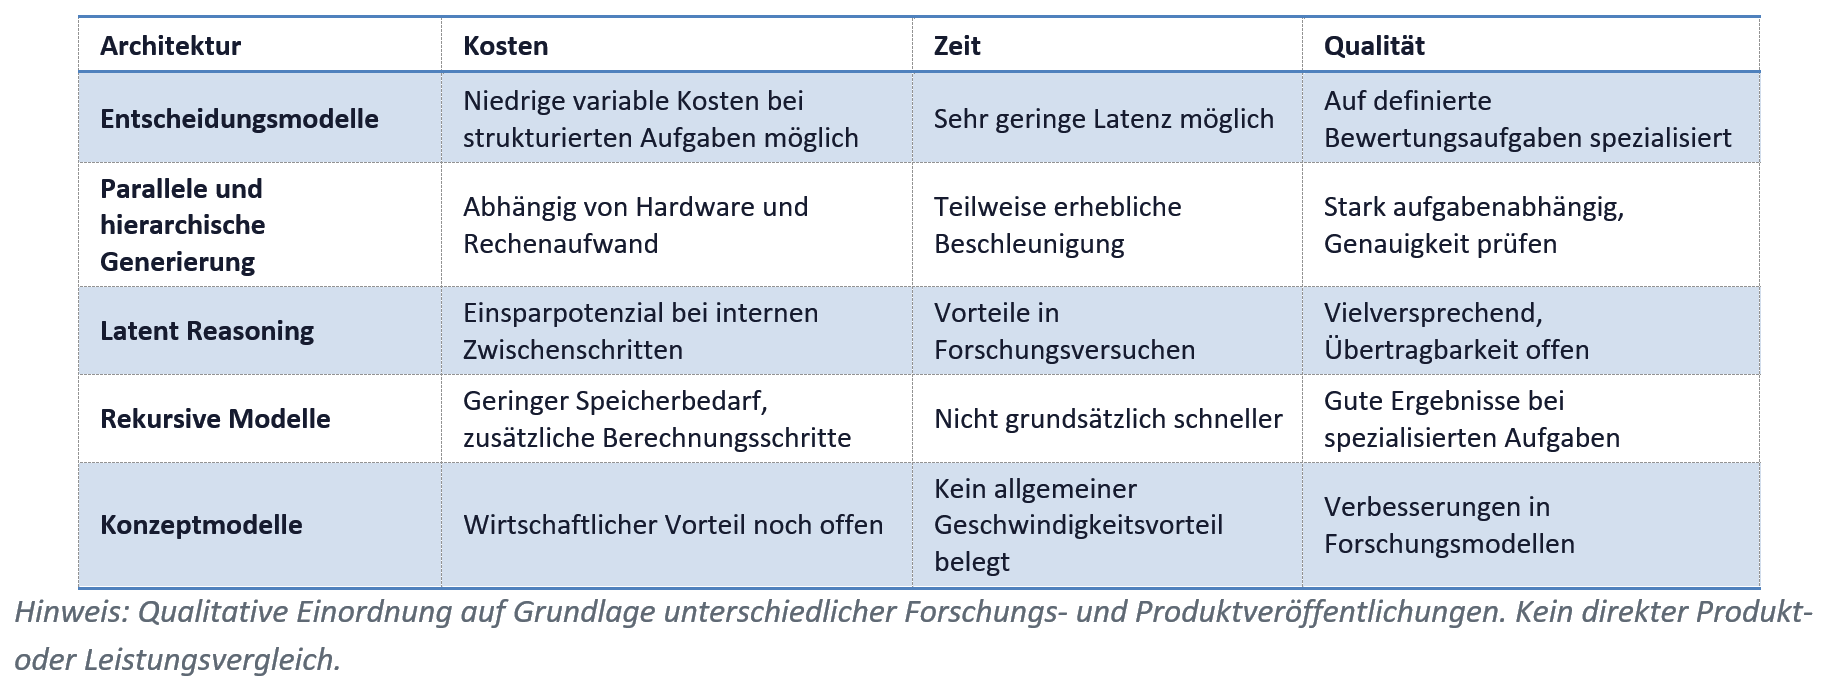
Die fünf Entwicklungsrichtungen verfolgen unterschiedliche technische Ziele. Einige sind bereits kommerziell verfügbar, andere befinden sich noch in einer experimentellen Phase. Ihre Leistungswerte wurden zudem unter unterschiedlichen Bedingungen ermittelt. Eine direkte Rangfolge wäre deshalb wenig sinnvoll. Die folgende Übersicht fasst zusammen, wo derzeit die wesentlichen Potenziale und Grenzen liegen.
Spezialisierung wird wichtiger
Die zunehmende Vielfalt der Modelle erweitert die Möglichkeiten, KI-Anwendungen gezielt aufzubauen. Ein Unternehmen könnte beispielsweise ein Entscheidungsmodell zur Dokumentenklassifikation, ein generatives Modell zur Informationsextraktion und klassische Software zur Prüfung eindeutig definierter Bedingungen einsetzen. Eine solche Architektur ist schon heute möglich. Neue spezialisierte Modelle können sie wirtschaftlich attraktiver machen. Allerdings erhöht jede zusätzliche Komponente auch den Integrationsaufwand und schafft möglicherweise neue Fehlerquellen oder Anbieterabhängigkeiten.
Entscheidend ist deshalb nicht, möglichst viele neue Modellarchitekturen einzusetzen, sondern für jede Aufgabe die geeignete Lösung zu wählen. Der relevante Maßstab bleibt die Leistungsfähigkeit des gesamten Prozesses.
Kontrollierbarkeit bleibt eine Aufgabe der Systemarchitektur
Mit wachsender Spezialisierung gewinnen außerdem Datenqualität, Schnittstellen, Berechtigungen und die Überwachung von Verarbeitungsschritten an Bedeutung. Ein einzelnes Modell kann korrekte Ergebnisse liefern, während das Gesamtsystem dennoch fehlerhaft arbeitet. Für Unternehmen ist deshalb zwischen technischer Transparenz, Nachvollziehbarkeit und Kontrollierbarkeit zu unterscheiden. Nicht jeder interne Zustand muss unmittelbar verständlich sein. Abhängig vom Anwendungsfall muss aber überprüfbar sein, welche Informationen verarbeitet, welche Aktionen ausgeführt und welche Ergebnisse erzeugt wurden.
Die europäische KI-Verordnung, der Artificial Intelligence Act, stellt für bestimmte Hochrisiko-KI-Systeme Anforderungen an Protokollierung, Transparenz und menschliche Aufsicht. Eine pauschale Pflicht zur Offenlegung sämtlicher interner Modellberechnungen ergibt sich daraus nicht. Die konkrete Ausgestaltung der Kontrollen muss sich am jeweiligen System und seinen Risiken orientieren.
Die technologische Entwicklung verändert damit nicht zwangsläufig die grundlegenden Anforderungen an verantwortungsvolle KI. Sie vergrößert vor allem die Zahl der technischen Möglichkeiten, diese Anforderungen umzusetzen.
Einen organisatorischen Rahmen für die Steuerung solcher Anforderungen bietet die ISO/IEC 42001. Der internationale Standard beschreibt Anforderungen an ein KI-Managementsystem, mit dem Unternehmen Verantwortlichkeiten, Risiken und Kontrollmaßnahmen über den gesamten Lebenszyklus ihrer KI-Anwendungen hinweg systematisch steuern können. Er kann die Umsetzung regulatorischer Anforderungen unterstützen, ersetzt deren eigenständige Prüfung jedoch nicht.
Fazit: Die Architektur wird wieder zum Innovationstreiber
Die vorgestellten Forschungs- und Produktlinien zeigen, dass der Fortschritt künstlicher Intelligenz auf unterschiedlichen Ebenen stattfindet. Manche Verfahren verzichten auf freie Textgenerierung, andere verändern deren Ablauf. Wieder andere setzen bei internen Berechnungen oder der Repräsentation von Informationen an. Daraus ergibt sich keine zwangsläufige Ablösung großer Sprachmodelle. Vielmehr dürften unterschiedliche Ansätze nebeneinander bestehen, sich ergänzen oder in bestehende Modellfamilien integriert werden.
Für Unternehmen wird es deshalb wichtiger, KI-Anwendungen nicht allein anhand einzelner Modellvergleiche zu planen. Entscheidend ist, welcher technische Ansatz eine konkrete Aufgabe mit angemessener Qualität, vertretbarer Bearbeitungszeit und wirtschaftlich sinnvollem Ressourceneinsatz erfüllt.
Die nächste Entwicklungsphase der KI könnte weniger davon geprägt sein, wie groß wir Modelle machen, sondern davon, wie intelligent wir unterschiedliche Wege der Informationsverarbeitung nutzen.
Neue KI-Architekturen eröffnen technische Möglichkeiten. Die Herausforderung für Unternehmen liegt darin, diese kontrolliert und wirtschaftlich sinnvoll einzusetzen. Wenn Sie sich mit KI-Governance, der EU-KI-Verordnung oder ISO/IEC 42001 beschäftigen, freue ich mich über den Austausch.
Verfasser: Sebastian Berger
Quellen und weiterführende Literatur
Die direkt im Text verlinkten Veröffentlichungen umfassen technische Herstellerinformationen und wissenschaftliche Forschungsarbeiten. Leistungszahlen aus Herstellervergleichen und experimentellen Benchmarks sind nicht zwangsläufig unabhängig reproduziert und erlauben keinen unmittelbaren Vergleich der vorgestellten Architekturansätze.
Entscheidungsmodelle: TypeSafe AI, Jev